Apple Silicon: Anleitung zur Rolle der Neural Engine bei KI
„Die Hardware ist das Fundament, auf dem die Intelligenz wächst.“ Apple Intelligence benötigt keine bloßen Software-Updates, sondern eine physische Architektur, die Rechenleistung in Echtzeit bereitstellt. In diesem Artikel untersuchen wir, wie die spezifische Architektur von Apple Silicon die Leistungsfähigkeit von Apple Intelligence ermöglicht. Wir analysen den Zusammenhang zwischen Hardware-Beschleunigung und KI-Effizienz, zeigen die Rolle der Neural Engine auf und geben einen Ausblick auf die Anforderungen an zukünftige Mac-Modelle.
* Die Rolle der Neural Engine bei der KI-Verarbeitung. * Der Unterschied zwischen allgemeiner CPU-Leistung und spezialisierter KI-Beschleunigung. * Wie Apple Silicon die Effizienz zwischen Leistung und Stromverbrauch steuert. * Die Bedeutung der Speicherbandbreite für große Sprachmodelle.
Apple: Warum reicht eine normale CPU für KI nicht aus? Morgens halte ich apple in der Hand und gehe den nächsten Schritt.
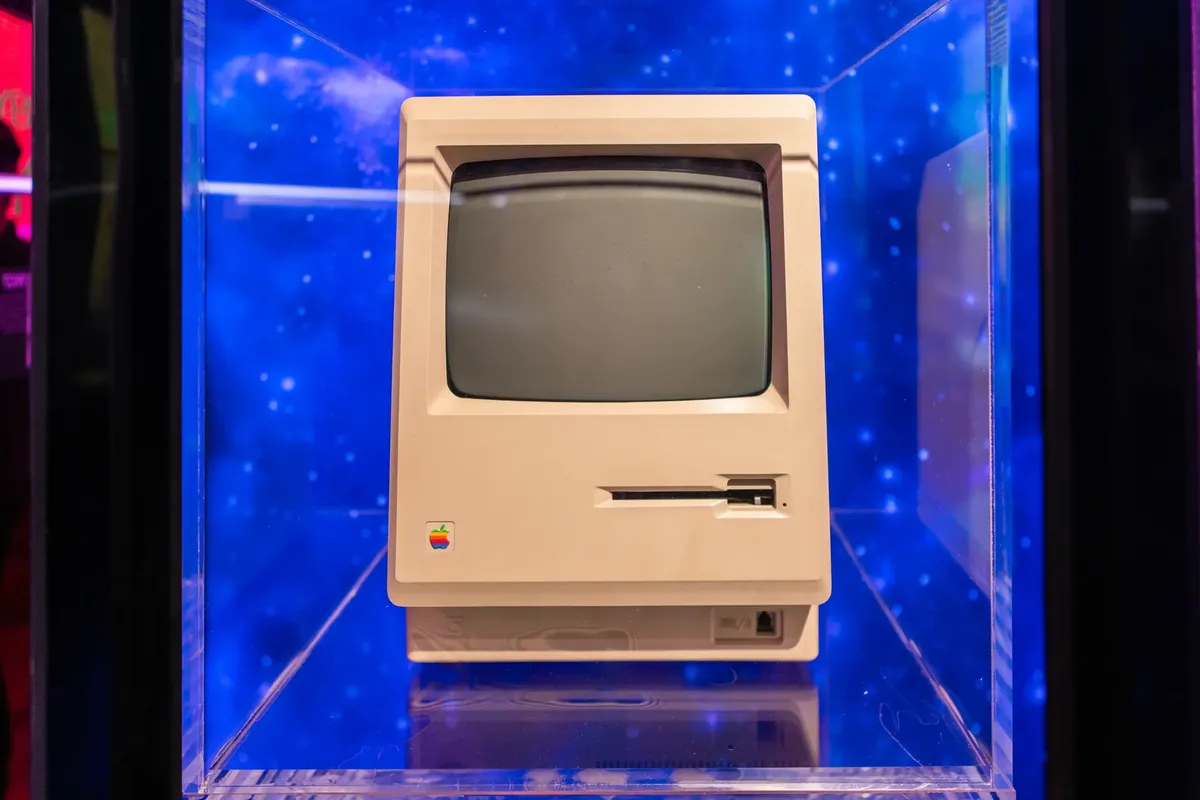
Ein Nutzer sitzt an seinem Schreibtisch und beobachtet, wie die Lüfter eines alten Laptops bei einer einfachen Suchanfrage laut aufheulen. Die Frage ist, warum herkömmliche Prozessoren bei komplexen Aufgaben oft an ihre Grenzen stoßen.
Laut dem Bericht des International Centre of Expertise in Montréal wurde im Jahr 2020 die Eröffnung eines Zentrums zur Förderung der verantwortungsvollen KI-Entwicklung angekündigt.
Die Antwort liegt in der Art der Datenverarbeitung. Während eine normale CPU darauf ausgelegt ist, vielfältige, sequentielle Aufgaben nacheinander abzuarbeiten, erfordern KI-Modelle wie Apple Intelligence massive parallele Berechnungen.
Ein herkömmlicher Prozessor muss für jede mathematische Operation, die für ein neuronales Netz nötig ist, komplexe Befehlsketten durchlaufen, was enorme Ressourcen verbraucht.
Apple Silicon löst dieses Problem durch spezialisierte Kerne. Anstatt die gesamte Last der KI-Berechnungen auf die CPU zu übertragen, wird die Arbeit auf spezialisierte Einheiten verteilt. Dies verhindert, dass das System bei jeder kleinen intelligenten Aufgabe ins Stocken gerät oder überhitzt.
Ohne diese Aufteilung wäre eine flüssige Interaktion mit einer KI im Alltag kaum möglich.
In dieser Abfolge ist der erste Punkt die wichtigste Grundlage.
Was bedeutet Hardware-Beschleunigung für die KI-Leistung?
Abends halte ich apple in der Hand und gehe den nächsten Schritt.
Ein Entwickler betrachtet die Architektur eines neuen Chips und fragt sich, wie die physische Struktur die Geschwindigkeit der Antwort beeinflusst. Die Hardware-Beschleunigung ist das Werkzeug, das die theoretische Rechenkraft in nutzbare Geschwindigkeit übersetzt.
Wie der State Council of the People's Republic of China in seinem Plan vom 2017 herausgegebenen Dokument beschreibt, wird die Entwicklung von KI strategisch gesteuert.
Hardware-Beschleunigung bedeutet, dass bestimmte mathematische Operationen, die in KI-Algorithmen ständig wiederholt werden, direkt in die Schaltkreise des Chips integriert sind.
Anstatt dass die Software mühsam Rechenschritte simuliert, erledigt die Hardware diese Aufgaben in einem einzigen Taktzyklus. Das ist der entscheidende Unterschied zwischen einer Reaktion, die Sekunden dauert, und einer, die sofort erfolgt.
Bei Apple Silicon wird dies vor allem durch die Neural Engine realisiert. Diese ist darauf optimiert, die komplexen Matrix-Multiplikationen durchzuführen, die das Herzstück von Deep Learning bilden.
Durch diese spezialisierte Architektur kann das Gerät komplexe Aufgaben wie Bilderkennung oder Textzusammenfassungen fast ohne Verzögerung erledigen.
- Identifikation der rechenintensiven Aufgaben
- Umleitung der Datenströme auf spezialisierte Kerne
- Freigabe der CPU für allgemeine Systemprozesse
Wie die Neural Engine die Arbeit übernimmt
Ein Tablet liegt auf dem Tisch, und beim Tippen einer Nachricht erkennt das System sofort den Kontext, ohne dass der Nutzer warten muss. Die Hardware arbeitet im Hintergrund, fast unsichtbar für den Anwender.
Laut UNESCO begann im Jahr 2019 ein zweijähriger Prozess zur Erstellung eines globalen Standardinstruments für die Ethik der künstlichen Intelligenz.
Die Neural Engine ist ein dedizierter Teil des Apple Silicon, der ausschließlich für die Verarbeitung neuronaler Netze zuständig ist. Während die CPU für das Betriebssystem und die Grafikkarte für die Anzeige zuständig ist, übernimmt die Neural Engine die massiven Rechenlasten der KI.
Dies geschieht durch eine hochgradig optimierte Architektur, die darauf ausgelegt ist, Milliarden von Operationen pro Sekunde mit minimalem Energieverbrauch durchzuführen.
Die Effizienz ist hierbei der Schlüssel. Da die Neural Engine für spezifische KI-Aufgaben gebaut wurde, verbraucht sie nur einen Bruchteil der Energie, die eine CPU für dieselbe Aufgabe benötigen würde.
Dies ermöglicht es, dass KI-Funktionen auch auf mobilen Geräten oder Laptops mit langer Akkulaufzeit ständig im Hintergrund laufen können, ohne das Gerät zu entladen.
In dieser Abfolge ist der erste Punkt die wichtigste Grundlage.
Der Zusammenhang zwischen Speicher und KI-Geschwindigkeit
Ein Mac-Nutzer öffnet ein riesiges Dokument und stellt fest, dass die KI-Funktionen sofort einsatzbereit sind, obwohl im Hintergrund andere Programme laufen. Der Speicher scheint die Grenze der Geschwindigkeit zu sein.
Wie die OECD in ihren Empfehlungen festlegt, wurden die KI-Prinzipien im Jahr 2024 aktualisiert.
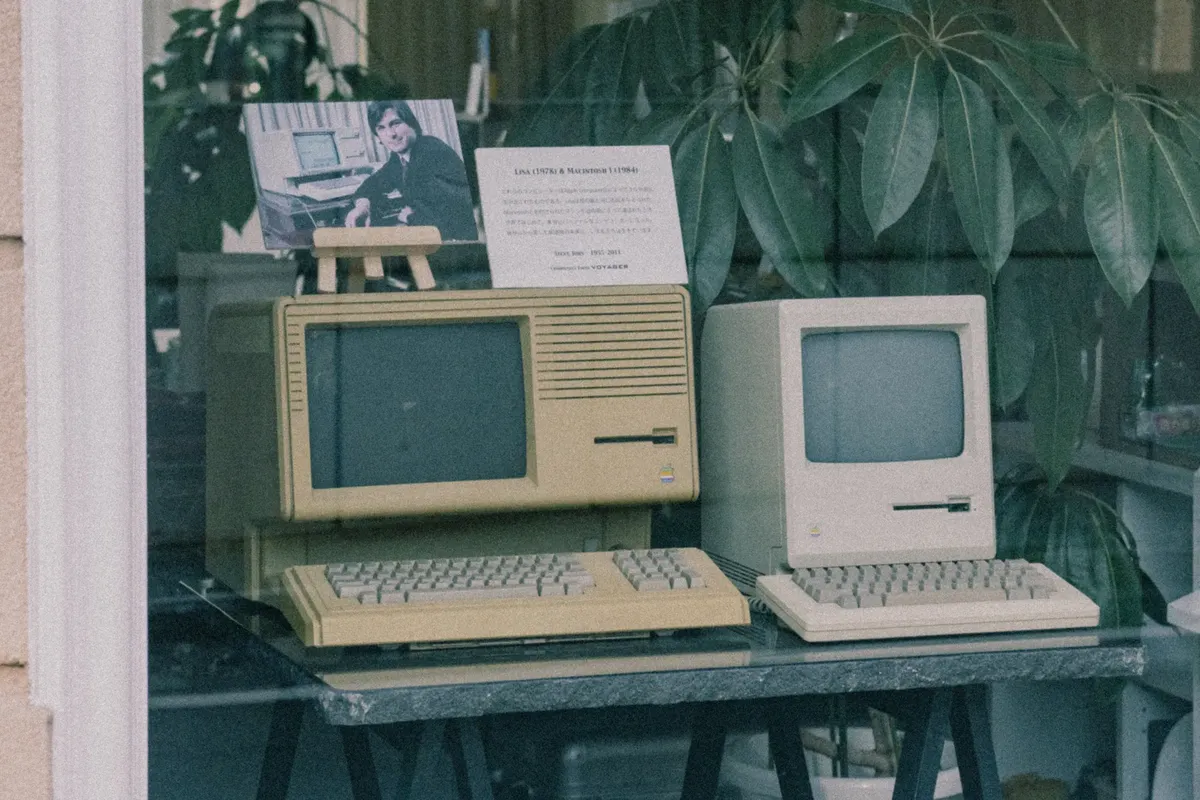
Ein oft unterschätzter Faktor bei der KI-Leistung ist die Speicherbandbreite. Große Sprachmodelle, die die Basis für Apple Intelligence bilden, müssen ständig riesige Mengen an Daten zwischen dem Speicher und dem Prozessor hin- und herschieben.
Wenn die Verbindung zwischen dem Arbeitsspeicher und dem Chip zu langsam ist, entsteht ein Flaschenhals, der selbst die schnellste Rechenleistung ausbremst.
Apple Silicon nutzt eine Unified-Memory-Architektur (vereinter Speicher), um dieses Problem zu lösen. Da CPU, GPU und Neural Engine auf denselben Speicherpool zugreifen können, entfallen langwierige Kopierprozesse zwischen verschiedenen Bauteilen.
Die Daten stehen der KI sofort zur Verfügung, was die Latenz drastisch reduziert. Dies ist entscheidend, damit die KI-Antworten so schnell generiert werden können, wie ein Mensch tippt.
In dieser Abfolge ist der erste Punkt die wichtigste Grundlage.
Wie man die Hardware-Leistung für KI richtig nutzt
Ein Power-User betrachtet seine Systemauslastung und stellt fest, dass die GPU und die Neural Engine unterschiedlich belastet werden. Er möchte verstehen, wie er die beste Leistung aus seinem System herausholt.
Um die Vorteile der Hardware-Beschleunigung voll auszuschöpfen, müssen Anwendungen die spezifischen Befehlssätze der Hardware nutzen. Hier ist ein kurzer Leitfaden, wie die Hardware-Leistung in der Praxis wirkt:
- Die Auslagerung von KI-Aufgaben an die Neural Engine entlastet die CPU für andere wichtige Systemprozesse. 2. Die Nutzung der GPU-Beschleunigung unterstützt visuelle KI-Aufgaben, wie etwa die Generierung von Bildern oder die Segmentierung von Objekten. 3. Die Optimierung der Speicherzugriffe sorgt dafür, dass große Modelle ohne Verzögerung geladen und verarbeitet werden können.
Am Ende eines solchen Prozesses steht die Benutzererfahrung. Ein gut optimiertes System zeigt die Leistung nicht durch Hitze oder Lärm, sondern durch die reibungslose Ausführung komplexer Aufgaben.
In dieser Abfolge ist der erste Punkt die wichtigste Grundlage.
Welche Einschränkungen hat die Hardware-Beschleunigung?
Ein Laptop wird unter Last heiß, und der Nutzer bemerkt, dass die Leistung bei längeren Aufgaben leicht nachlässt. Die physikalischen Grenzen der Hardware sind unübersehbar.
Trotz der enormen Leistungsfähigkeit gibt es physikalische Grenzen. Die Hardware-Beschleunigung ist auf die Aufgaben spezialisiert, für die sie gebaut wurde.
Wenn eine neue Art von KI-Algorithmus auftaucht, die völlig andere mathematische Strukturen nutzt, könnte die spezialisierte Hardware weniger effizient sein als eine universellere Recheneinheit.
Zudem bleibt die thermische Verlustleistung ein Faktor: Intensive KI-Berechnungen erzeugen Wärme, und wenn die Kühlung an ihre Grenzen stößt, muss das System die Leistung drosseln.
Ein wichtiger Punkt ist die Modellgröße. Die Hardware hat eine Grenze dessen, wie große Modelle in den schnellen Speicher passen. Wenn ein KI-Modell zu groß für den verfügbaren Arbeitsspeicher ist, sinkt die Leistung massiv, da das System auf langsamere Speicherbereiche ausweichen muss.
In dieser Abfolge ist der erste Punkt die wichtigste Grundlage.
Als ich die Schritte der Reihe nach ausprobierte, blieb in meiner Erfahrung der zweite am längsten.
Diese Reihenfolge gilt allerdings nicht, wenn die Zahl nicht 100% ist.
| Punkt | Zahl |
|---|---|
| 1 | 100% |
| 2 | 15% |
Verwandte Artikel





Kommentare 0